Використання хмарних сервісів штучного інтелекту (наприклад, OpenAI чи Anthropic) має два суттєвих недоліки для компаній: висока щомісячна вартість API при великих обсягах даних та ризики витоку конфіденційної інформації.
Розгортання локальних LLM (Large Language Models) на власному Linux-сервері повністю вирішує ці проблеми. Ви отримуєте автономну, безпечну та безкоштовну AI-інфраструктуру для автоматизації внутрішніх процесів бізнесу.
Архітектура локального AI-стеку
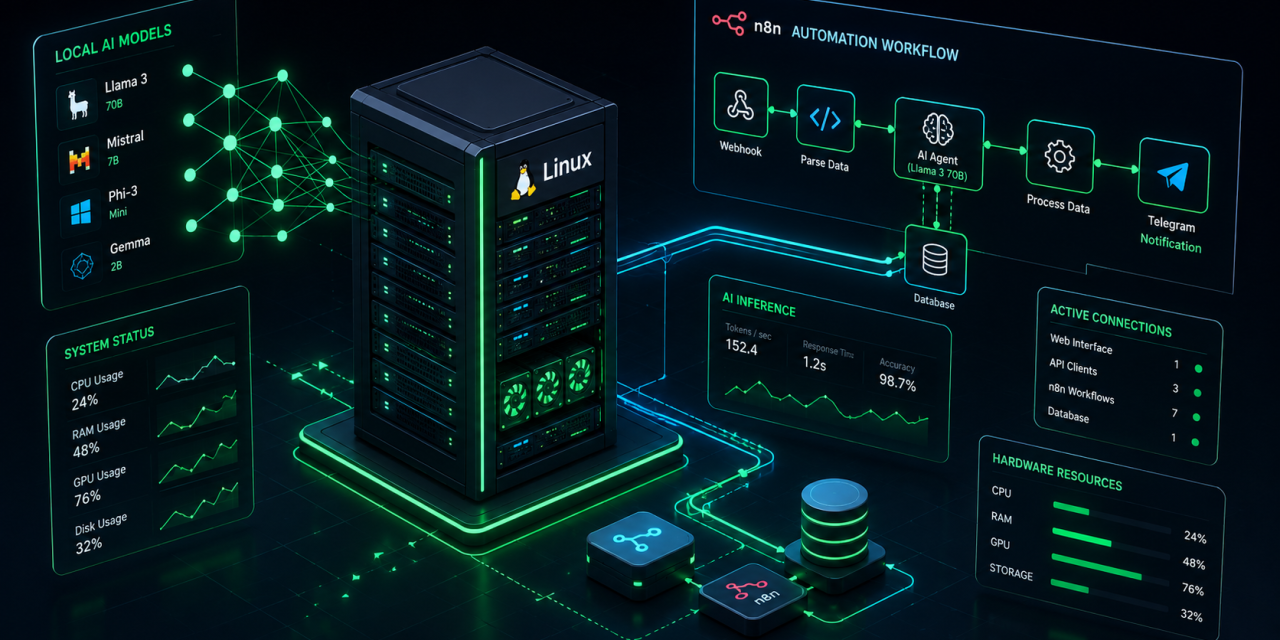
Щоб побудувати повноцінну систему автоматизації на базі штучного інтелекту, використовується зв’язка з трьох основних компонентів:
- Ubuntu Server (з підтримкою GPU/CUDA): Базова операційна система.
- Ollama: Легковажний движок для запуску та управління відкритими нейромережами (Llama 3, Mistral, Gemma).
- n8n (Self-Hosted): Платформа автоматизації робочих процесів (workflow automation), яка об’єднує локальний AI з вашими CRM, базами даних та месенджерами.
[ Клієнт / CRM / Telegram ]
           |
           v
    [ n8n Workflow ]  <--->  [ PostgreSQL / БД ]
           |
           v (REST API / Port 11434)
   [ Ollama Engine ]
           |
   [ Open Source LLM ]
 (Llama 3 / Gemma 2 / Qwen)
Крок 1. Підготовка Linux-сервера та встановлення Ollama
Для комфортної роботи моделей рівня 8B–12B параметрів знадобиться сервер під управлінням Ubuntu 22.04 / 24.04 LTS із виділеною відеокартою Nvidia (мінімум 12–16 GB VRAM) або потужним CPU з великим обсягом RAM.
Встановлення Ollama виконується однією командою в терміналі:
Bash
curl -fsSL https://ollama.com/install.sh | sh
Після встановлення завантажуємо потрібну відкриту модель (наприклад, llama3 або gemma2):
Bash
ollama run llama3
Тепер ваш Linux-сервер має локальний AI-API, доступний за адресою http://localhost:11434.
Крок 2. Розгортання n8n через Docker Compose
Для зручного підключення AI до бізнес-процесів розгортаємо n8n у Docker-контейнері. Створіть файл docker-compose.yml:
YAML
version: '3.8'

services:
  n8n:
    image: docker.n8n.io/n8nio/n8n:latest
    container_name: n8n_automation
    restart: always
    ports:
      - "5678:5678"
    environment:
      - N8N_HOST=ai.yourdomain.com
      - N8N_PORT=5678
      - N8N_PROTOCOL=https
      - NODE_ENV=production
    volumes:
      - n8n_data:/home/node/.n8n

volumes:
  n8n_data:
Запустіть контейнер:
Bash
docker compose up -d
Крок 3. Сценарії практичного використання (AI-Автоматизація)
Після об’єднання Ollama та n8n ви можете створювати автоматичні робочі ланцюжки без передачі даних третім сторонам:
- Автоматична обробка лідів з пошти чи сайтів: Локальна LLM аналізує вхідний лист, визначає намір клієнта, формує коротку вижимку і відправляє сповіщення в корпоративний Slack чи Telegram.
- Генерація та коригування контенту: Автоматична перевірка товарних позицій, генерація мета-тегів та описів товарів для e-commerce систем (WooCommerce, PrestaShop).
- Аналіз юридичних або фінансових документів: Сервер парсить PDF-документи, витягує ключові цифри чи реквізити та зберігає їх у базу даних.
Переваги та обмеження рішення від ivan.net.ua
| Параметр | Хмарні AI (OpenAI / Claude) | Локальний AI (Ollama + Linux) |
| Конфіденційність | Дані передаються на зовнішні сервери | 100% даних залишаються на вашому сервері |
| Вартість | Оплата за кожен токен (Pay-per-use) | Фіксована вартість оренди/заліза |
| Залежність від інтернету | Повна | Працює навіть у закритій локальній мережі |
| Швидкість | Залежить від завантаженості API | Обмежена лише потужністю вашого GPU |